Published on 19 Nov 2026
min read
Views
I de flesta av de anläggningar vi arbetar med löstes anslutningsproblemen för flera år sedan.
PLC:er kommunicerar med SCADA, SCADA matar en historikdatabas och någonstans kopierar en pipeline taggar till en datalagring. Då ställer en driftsäkerhetsingenjör en rimlig fråga: vilka kritiska pumpar riskerar att gå sönder före nästa planerade driftstopp, och finns reservdelarna på plats?
Svaret kräver fortfarande veckor av arbete i kalkylblad – en brist som utgör den verkliga OT/IT-utmaningen i AI-eran.
Streaming- och publicerings-/prenumerationsmönster har funnits i årtionden, och att flytta data från en PLC, ett SCADA-system, en historikdatabas eller en MQTT-mäklare till en företagsplattform är inte längre utmaningen. Vad organisationer i allt högre grad behöver är förmågan att omvandla högfrekventa industriella signaler till reglerade, återanvändbara dataprodukter – med tillräckligt med sammanhang och förtroende bakom sig så att analys, maskininlärning och operativa beslut kan baseras på dem.
På Databricks handlar det om fem arkitekturbeslut.
1. Bestäm vad som kvalificerar sig som en ström
Inte varje PLC-tagg behöver en realtidspipeline. En avvikelse i vibrationer eller lagertemperatur som kräver åtgärd inom några sekunder kan motivera Structured Streaming, som på Databricks nu inkluderar ett realtidsläge för operativa arbetsbelastningar. En produktionsräknare som uppdateras varje timme gör det inte. Det är billigare och enklare att lagra den som filer och hämta den med Auto Loader eller ett schemalagt jobb.
Ett användbart test: om ingen person eller något system kommer att agera på en signal inom några minuter behöver den förmodligen inte strömmas. I den andra ytterligheten hör allt som måste stänga av en maskin inom millisekunder hemma i kontrollskiktet, inte i molnet. Latens, kostnad, tillförlitlighet och operativt värde måste vägas signal för signal.
2. Låt historikern behålla sin uppgift
Historikerna förblir avgörande för anläggningsdriften, lagring av tidsserier med hög upplösning och användningsfall i kontrollrummet.
Operatörerna litar på dem, och att ta bort en historikdatabas motiverar sällan den störning det medför. Databricks behöver inte ersätta historikdatabasen. Det bästa tillvägagångssättet är att använda Lakehouse som företagslagret ovanför den – platsen för domänöverskridande analys, AI, optimering och långsiktig industriell intelligens som ingen enskild anläggnings historikdatabas är utformad för att leverera.
3. Skapa dataprodukter, inte telemetridump
Arbetet börjar med att lägga in OPC UA- eller MQTT-data i Delta Lake-tabeller. En tagg som heter TT_4021_PV betyder inte mycket för en dataforskare förrän den kopplas till en tillgångshierarki, underhållshistorik, produktionssammanhang, kvalitetshändelser och poster från ERP-, MES-, CMMS- och EAM-system.
När vi tillkännagav vårt partnerskap med Databricks stod det klart att flaskhalsen ”aldrig har varit data; det har varit sammanhanget”.
Så här ser det ut i praktiken. En vibrationssignal från en roterande tillgång strömmar in i Delta Lake och kopplas samman med tillgångens underhållshistorik för att skapa en tabell med maskinhälsoegenskaper. En modell som hanteras med MLflow ger den ett betyg, och ett stigande riskbetyg utlöser ett underhållsmeddelande i SAP PM eller vilket system anläggningen än använder. Varje steg lämnar efter sig något som kan återanvändas, vilket är skillnaden mellan en dataprodukt och en hög med telemetri.
4. Styr från dag ett
”Låt oss först samla in data och styra den senare” är en av de dyraste meningarna i ett industriellt dataprogram. När det väl är dags för styrning har tre team byggt tre versioner av samma taggmappning, och ingen kan säga vilken som matas in i modellen.
OT-data behöver härkomst, ägarskap, kvalitetsregler, åtkomstkontroller på anläggningsnivå, konsekvent semantik och spårbarhet redan från början. Det är här Unity Catalog spelar en viktig roll, eftersom det tillämpar en enda modell för behörigheter, härkomst och granskning på OT-data, IT-data och de modeller som byggs på båda.
5. Slut cirkeln i driften
En översiktspanel för utrustningens hälsa är inte mållinjen. Värdet uppstår när prognoserna förändrar vad som händer på golvet: en arbetsorder skapas, en produktionsplan justeras, en kvalitetsrisk flaggas innan satsen levereras. Det kräver att den industriella dataplattformen kopplas samman med ERP, MES, CMMS, kvalitetssystem och digitala tvillingmiljöer, så att insikterna hamnar där planerare och tekniker redan arbetar. Det är samma anledning till att vårt Asset Health Framework är byggt för att agera utifrån vad det diagnostiserar.
Det finns inget enda rätt mönster
Beroende på anläggningens förutsättningar kan båda dessa vara giltiga:
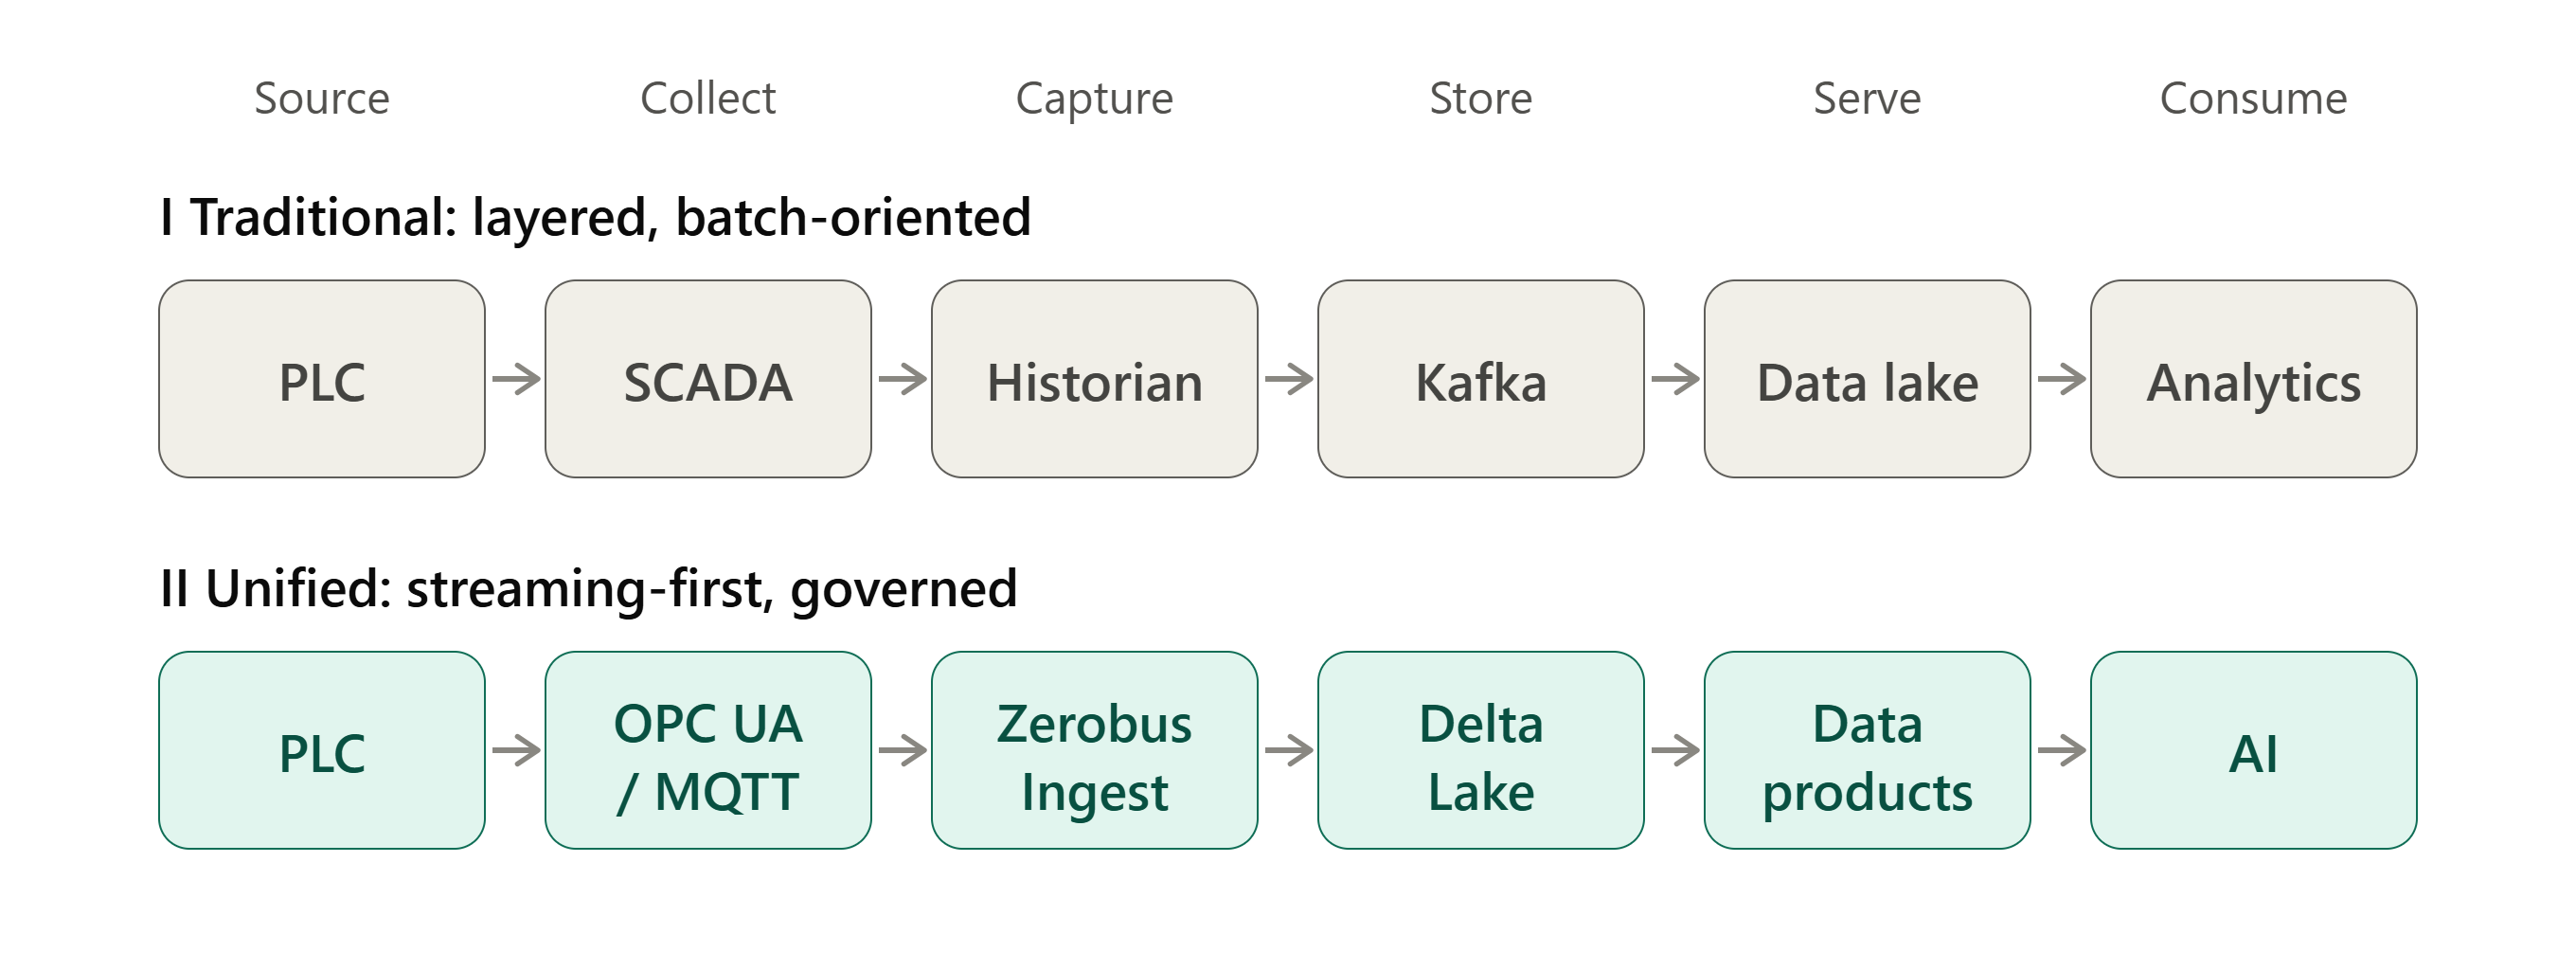
Det första passar befintliga anläggningar med etablerade historikdatabaser och en Kafka-ryggrad som redan betjänar flera användare, medan det andra eliminerar mellanled.
Med Zerobus Ingest skickar lätta vidarebefordrare i edge-miljön händelser direkt till reglerade Delta-tabeller, utan att någon meddelandebuss fungerar som mellanlagringsområde. Databricks är tydliga med att de inte ersätter en buss när flera operativa system konsumerar samma händelser, så valet beror på vem mer som behöver data, inte på vilket diagram som ser modernare ut.
Vart detta är på väg
Målet är en enhetlig, reglerad dataplan där driftsystem, företagssystem, analysverktyg och AI alla arbetar utifrån samma tillförlitliga industriella data. Att nå dit kräver lika mycket anläggningsteknik som datateknik, vilket är anledningen till att vårt FactoryNext-ramverk har en leverantörsneutral strategi och bygger vidare på de IT- och OT-investeringar som en anläggning redan har gjort.
Maskinen kommer alltid att vara viktig. Men i AI-eran är en av de mest värdefulla tillgångarna på verkstadsgolvet den reglerade dataprodukten som byggs upp utifrån maskinens signaler.