公開日19 Nov 2026
最小読み取り時間
ビュー
当社が関わるプラントのほとんどにおいて、接続性の問題は数年前に解決済みです。
PLCはSCADAと通信し、SCADAはヒストリアンにデータを送り、どこかのパイプラインがタグデータをデータレイクにコピーします。そこで、信頼性エンジニアが当然の疑問を投げかけます。「次の計画停止までに、どの重要ポンプが故障する可能性が高いのか? そして、予備品は現場にあるのか?」
その答えを出すには、依然として数週間にわたるスプレッドシート作業が必要であり、このギャップこそが、AI時代のOT/ITが直面する真の課題なのです。
ストリーミングやパブリッシュ/サブスクライブのパターンは数十年前から存在しており、PLC、SCADAシステム、ヒストリアン、あるいはMQTTブローカーからエンタープライズプラットフォームへデータを移行すること自体は、もはや課題ではありません。 組織がますます必要としているのは、高頻度の産業用信号を、ガバナンスが施され再利用可能なデータ製品に変換する能力です。その背後には、分析、機械学習、および運用上の意思決定がそれらに依存できるよう、十分なコンテキストと信頼性が備わっていなければなりません。
Databricksにおいて、これを実現するには5つのアーキテクチャ上の決定事項があります。
1. 何がストリームとして扱われるかを決定する
すべてのPLCタグにリアルタイムパイプラインが必要なわけではありません。数秒以内に注意を要する振動や軸受温度の異常については、Structured Streamingの利用が妥当です。Databricks上のStructured Streamingには、現在、運用ワークロード向けのリアルタイムモードが搭載されています。 一方、1時間ごとの生産カウンターには必要ありません。これをファイルとして保存し、Auto Loaderやスケジュールされたジョブで取り込む方が、コストも低く、シンプルです。
有用な判断基準として、数分以内にその信号に基づいて人またはシステムが何らかのアクションを起こさない場合は、おそらくストリーミングする必要はありません。反対の極端な例として、ミリ秒単位で機械を停止させなければならないようなものは、クラウドではなく制御層に属します。レイテンシ、コスト、信頼性、運用上の価値は、信号ごとに個別に検討する必要があります。
2. ヒストリアンは本来の役割に専念させる
ヒストリアンは、プラントの運用、高解像度の時系列データの保持、および制御室でのユースケースにおいて、依然として不可欠です。
オペレーターはヒストリアンを信頼しており、それを撤去しても、その混乱を正当化できることはめったにありません。Databricksはヒストリアンに取って代わる必要はありません。より適切なアプローチは、Lakehouseをその上のエンタープライズ層として活用することです。Lakehouseは、単一のプラントのヒストリアンでは提供できない、ドメイン横断的な分析、AI、最適化、および長期的な産業インテリジェンスを行う場となります。
3. テレメトリのダンプではなく、データ製品を構築する
OPC UAやMQTTのペイロードをDelta Lakeのテーブルに格納することから、作業は始まります。「TT_4021_PV」というタグは、資産階層、保守履歴、生産コンテキスト、品質イベント、そしてERP、MES、CMMS、EAMシステムからの記録と結びつけられるまでは、データサイエンティストにとってほとんど意味を成しません。
Databricksとの提携を発表した際、「ボトルネックは決してデータそのものではなく、コンテキストにある」ということが明らかになりました。
これが実際にどのように機能するかを説明します。回転資産からの振動信号がDelta Lakeにストリーミングされ、その資産の保守履歴と結合されて、機械の健全性を表す特徴量テーブルが構築されます。 MLflowで管理されるモデルがこれをスコアリングし、リスクスコアの上昇により、SAP PMやプラントで運用されているシステムでメンテナンス通知がトリガーされます。各ステップで再利用可能な成果物が残される点こそが、データプロダクトと単なるテレメトリの集積との違いです。
4. 初日からガバナンスを実施する
「まずはデータを収集し、ガバナンスは後で考えよう」というのは、産業用データプログラムにおいて最もコストのかかる言葉の一つです。ガバナンスが導入される頃には、3つのチームが同じタグマッピングの3つのバージョンを構築しており、どれがモデルに供給されているのか誰も分からなくなっています。
OTデータには、最初からデータリネージ、所有権、品質ルール、プラントレベルのアクセス制御、一貫したセマンティクス、および監査可能性が必要です。ここでUnity Catalogが重要な役割を果たします。なぜなら、OTデータ、ITデータ、およびそれらに基づいて構築されたモデルのすべてに、権限、リネージ、監査に関する単一のモデルを適用するからです。
5. 運用へのループを閉じる
設備の健全性を示すダッシュボードは、ゴールではありません。予測が現場での行動を変えたときに初めて価値が生まれます。例えば、作業指示書が作成されたり、生産計画が調整されたり、バッチが出荷される前に品質リスクが指摘されたりする場合です。 そのためには、産業用データプラットフォームがERP、MES、CMMS、品質管理システム、デジタルツイン環境と連携し、計画担当者や技術者が実際に業務を行っている現場にインサイトが届くようにする必要があります。これが、当社の「アセット・ヘルス・フレームワーク」が、診断結果に基づいて行動を起こせるように設計されている理由でもあります。
唯一の正解というものは存在しない
工場の状況によっては、以下の両方が有効な場合があります:
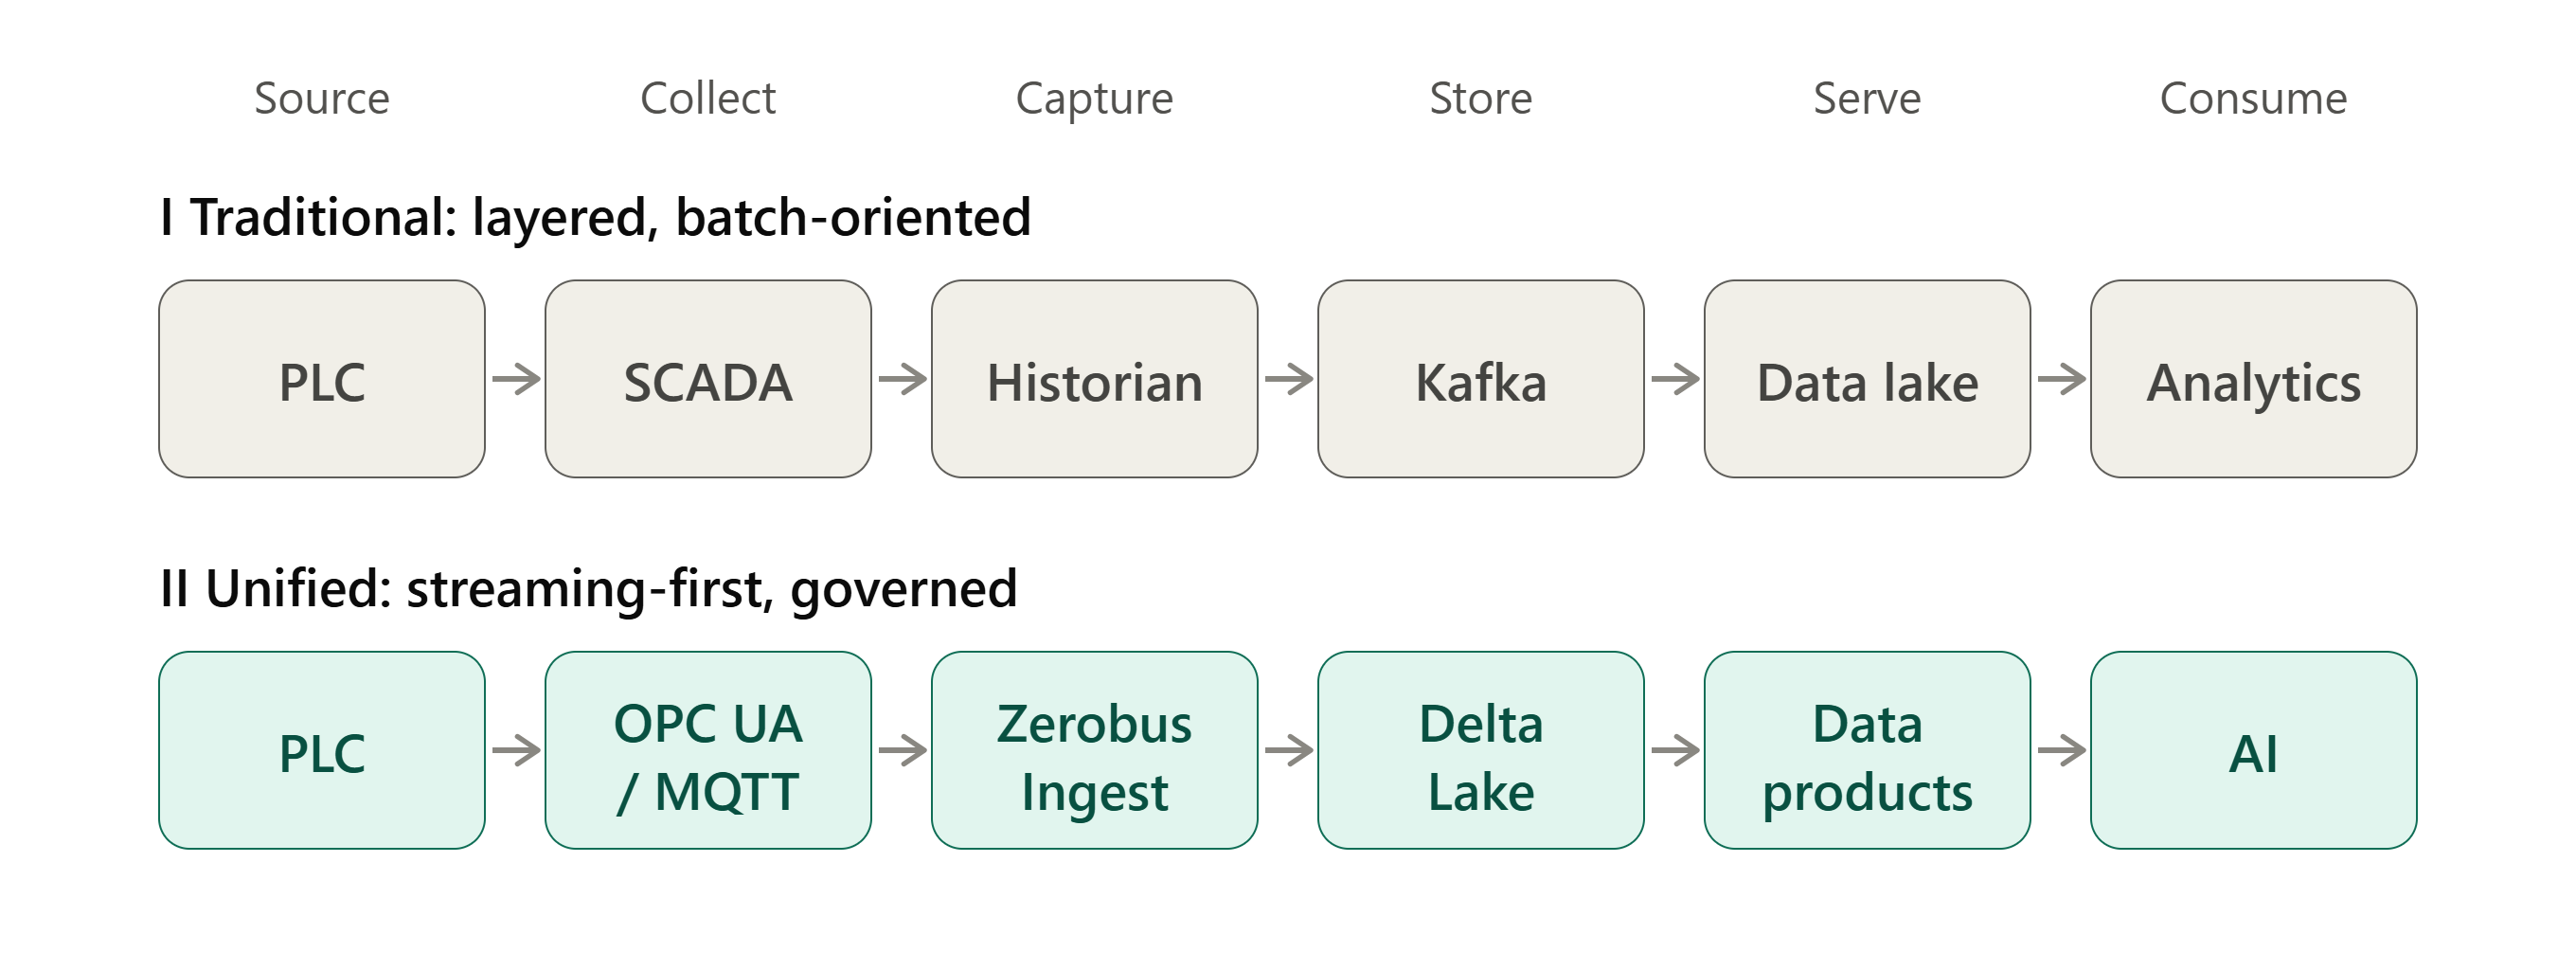
1つ目は、成熟したヒストリアンと、すでに複数のコンシューマーにサービスを提供しているKafkaバックボーンを備えたブラウンフィールドサイトに適しています。一方、2つ目は中継ステップを排除します。
Zerobus Ingestでは、エッジ側の軽量なフォワーディングエージェントが、メッセージバスをステージングエリアとして利用することなく、イベントを管理されたデルタテーブルに直接プッシュします。Databricksは、複数の運用システムが同じイベントを消費する場合、バスに取って代わるものではないと明確にしています。したがって、選択はどの図がより現代的に見えるかではなく、他に誰がデータを必要とするかによって決まります。
この取り組みの行方
その行き着く先は、運用システム、エンタープライズシステム、アナリティクス、AIがすべて、同じ信頼性の高い産業用データに基づいて動作する、統一されたガバナンスの適用されたデータプレーンです。そこに到達するには、データエンジニアリングと同じくらいプラントエンジニアリングも必要となります。そのため、当社のFactoryNextフレームワークはベンダー中立のアプローチを採用し、プラントがすでに保有するITおよびOTへの投資を基盤としています。
機械そのものは常に重要であり続けます。しかし、AI時代において、現場で最も価値のある資産の一つは、その機械の信号から構築されたガバナンスの効いたデータ製品なのです。