Veröffentlicht am19 Nov 2026
min lesen
Ansichten
In den meisten Anlagen, mit denen wir zusammenarbeiten, wurde das Problem der Vernetzung bereits vor Jahren gelöst.
SPSen kommunizieren mit SCADA, SCADA speist einen Historian, und irgendwo kopiert eine Pipeline Tags in einen Data Lake. Dann stellt ein Zuverlässigkeitsingenieur eine berechtigte Frage: Welche kritischen Pumpen werden wahrscheinlich vor der nächsten geplanten Abschaltung ausfallen, und sind die Ersatzteile vor Ort?
Die Beantwortung dieser Frage erfordert immer noch wochenlange Arbeit mit Tabellenkalkulationen – eine Lücke, die die eigentliche OT/IT-Herausforderung des KI-Zeitalters darstellt.
Streaming- und Publish/Subscribe-Muster gibt es schon seit Jahrzehnten, und die Übertragung von Daten aus einer SPS, einem SCADA-System, einem Historian oder einem MQTT-Broker in eine Unternehmensplattform ist längst keine Herausforderung mehr. Was Unternehmen zunehmend benötigen, ist die Fähigkeit, hochfrequente industrielle Signale in kontrollierte, wiederverwendbare Datenprodukte umzuwandeln – mit ausreichend Kontext und Vertrauen, damit sich Analysen, maschinelles Lernen und operative Entscheidungen darauf stützen können.
Bei Databricks läuft dies auf fünf Architekturentscheidungen hinaus.
1. Entscheiden Sie, was einen Stream rechtfertigt
Nicht jedes SPS-Tag benötigt eine Echtzeit-Pipeline. Eine Anomalie bei der Schwingung oder der Lagertemperatur, die innerhalb von Sekunden beachtet werden muss, kann den Einsatz von Structured Streaming rechtfertigen, das auf Databricks nun einen Echtzeitmodus für betriebliche Workloads umfasst. Ein stündlicher Produktionszähler hingegen nicht. Es ist kostengünstiger und einfacher, ihn als Dateien zu speichern und mit dem „Auto Loader“ oder einem geplanten Job abzurufen.
Ein nützlicher Test: Wenn keine Person oder kein System innerhalb von Minuten auf ein Signal reagiert, muss es wahrscheinlich nicht gestreamt werden. Am anderen Ende des Spektrums gehört alles, was eine Maschine innerhalb von Millisekunden abschalten muss, in die Steuerungsebene und nicht in die Cloud. Latenz, Kosten, Zuverlässigkeit und operativer Nutzen müssen Signal für Signal abgewogen werden.
2. Der Historian soll seine Aufgabe behalten
Historian-Systeme bleiben für den Anlagenbetrieb, die Speicherung hochauflösender Zeitreihen und Anwendungsfälle im Kontrollraum unverzichtbar.
Die Betreiber vertrauen ihnen, und eine Abschaffung rechtfertigt die damit verbundenen Störungen nur selten. Databricks muss den Historian nicht ersetzen. Sinnvoller ist es, das Lakehouse als darüberliegende Unternehmensschicht zu nutzen – als Ort für domänenübergreifende Analysen, KI, Optimierung und langfristige industrielle Intelligenz, für die kein einzelner Anlagen-Historian ausgelegt ist.
3. Datenprodukte erstellen, keine Telemetrie-Dumps
Die Arbeit beginnt erst damit, OPC-UA- oder MQTT-Nutzdaten in Delta-Lake-Tabellen zu speichern. Ein Tag namens TT_4021_PV sagt einem Datenwissenschaftler wenig, solange es nicht mit einer Anlagenhierarchie, der Wartungshistorie, dem Produktionskontext, Qualitätsereignissen und Datensätzen aus ERP-, MES-, CMMS- und EAM-Systemen verknüpft ist.
Bei der Bekanntgabe unserer Partnerschaft mit Databricks wurde deutlich, dass der Engpass „nie die Daten waren, sondern der Kontext“.
So sieht das in der Praxis aus: Ein Schwingungssignal von einer rotierenden Anlage wird in Delta Lake gestreamt und mit der Wartungshistorie der Anlage verknüpft, um eine Merkmalstabelle zum Maschinenzustand zu erstellen. Ein mit MLflow verwaltetes Modell bewertet diese, und ein steigender Risikowert löst eine Wartungsbenachrichtigung in SAP PM oder dem jeweiligen System des Werks aus. Jeder Schritt hinterlässt etwas Wiederverwendbares – das ist der Unterschied zwischen einem Datenprodukt und einem Haufen Telemetriedaten.
4. Governance vom ersten Tag an
„Lasst uns erst einmal die Daten einlesen und uns später um die Governance kümmern“ ist einer der kostspieligsten Sätze in einem industriellen Datenprogramm. Bis die Governance zum Tragen kommt, haben drei Teams drei Versionen derselben Tag-Zuordnung erstellt, und niemand kann sagen, welche davon in das Modell einfließt.
OT-Daten benötigen von Anfang an eine Herkunftsnachverfolgung, Verantwortlichkeiten, Qualitätsregeln, Zugriffskontrollen auf Anlagenebene, eine einheitliche Semantik und Nachvollziehbarkeit. Hier kommt Unity Catalog ins Spiel, da es ein einheitliches Modell für Berechtigungen, Herkunftsnachverfolgung und Audits auf OT-Daten, IT-Daten und die darauf aufbauenden Modelle anwendet.
5. Den Kreislauf im Betrieb schließen
Ein Dashboard zum Anlagenzustand ist nicht das Ziel. Der Mehrwert entsteht erst, wenn Vorhersagen das Geschehen in der Fertigung verändern: ein Arbeitsauftrag wird erstellt, ein Produktionsplan angepasst, ein Qualitätsrisiko wird vor dem Versand der Charge gemeldet. Dazu muss die industrielle Datenplattform mit ERP-, MES-, CMMS- und Qualitätssystemen sowie Digital-Twin-Umgebungen verbunden sein, damit die Erkenntnisse dort ankommen, wo Planer und Techniker bereits arbeiten. Aus demselben Grund ist unser „Asset Health Framework“ so konzipiert, dass es auf die von ihm gestellten Diagnosen reagiert.
Es gibt kein einziges richtiges Muster
Je nach Anlagenlandschaft können beide Ansätze gültig sein:
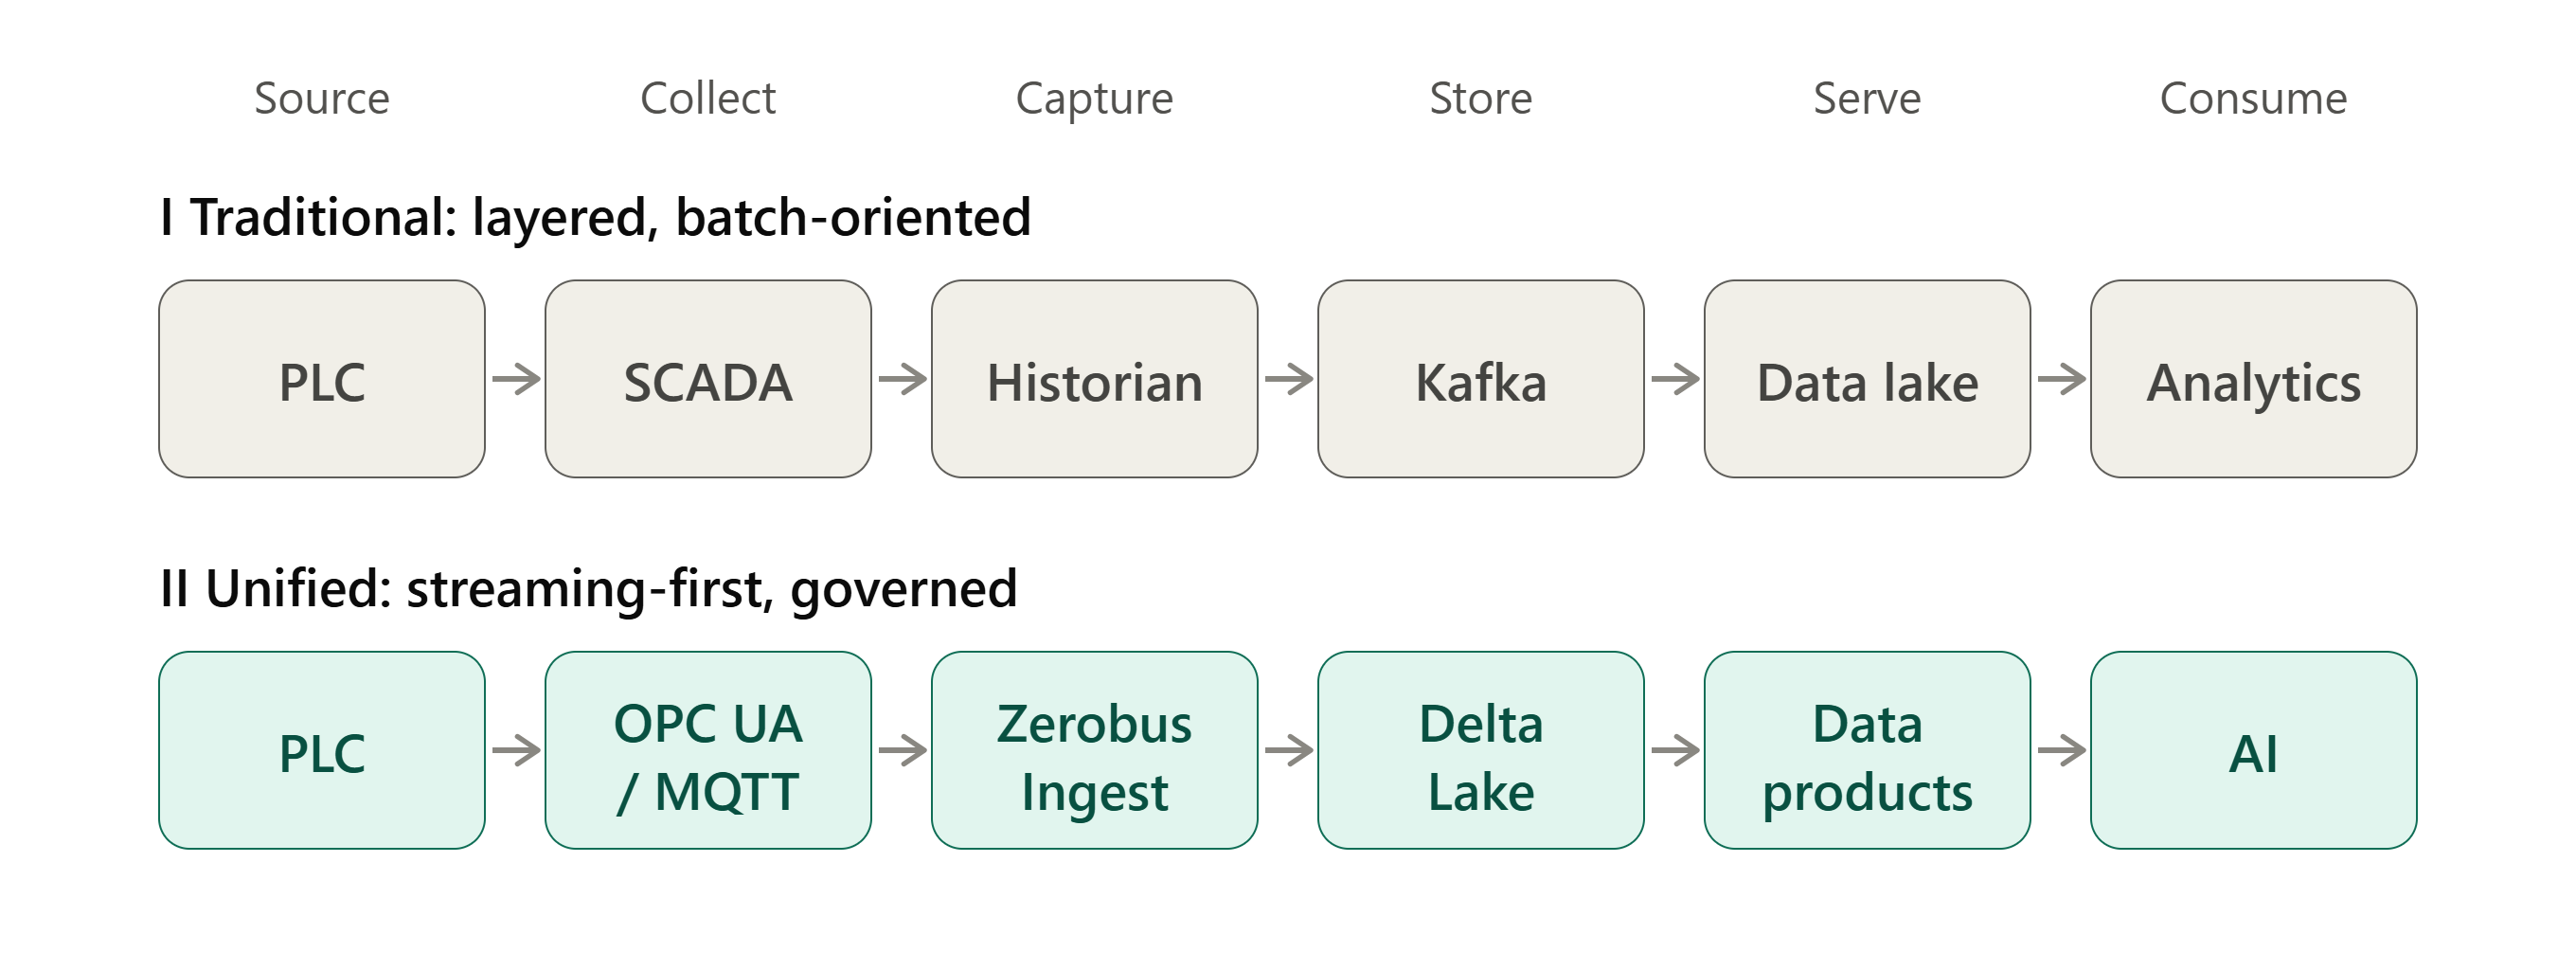
Der erste Ansatz eignet sich für Brownfield-Standorte mit ausgereiften Historian-Systemen und einem Kafka-Backbone, das bereits mehrere Verbraucher bedient, während der zweite Ansatz Zwischenstationen überflüssig macht.
Mit „Zerobus Ingest“ leiten schlanke Forwarding-Agenten am Edge Ereignisse direkt in regulierte Delta-Tabellen weiter, ohne dass ein Message-Bus als Zwischenablage dient. Databricks stellt klar, dass es einen Bus nicht ersetzt, wenn mehrere Betriebssysteme dieselben Ereignisse nutzen; daher hängt die Wahl davon ab, wer sonst noch die Daten benötigt, und nicht davon, welches Diagramm moderner aussieht.
Wohin die Reise geht
Das Ziel ist eine einheitliche, regulierte Datenebene, auf der Betriebssysteme, Unternehmenssysteme, Analytik und KI alle auf denselben vertrauenswürdigen Industriedaten basieren. Um dorthin zu gelangen, ist ebenso viel Anlagentechnik wie Datenengineering erforderlich. Deshalb verfolgt unser FactoryNext-Framework einen herstellerneutralen Ansatz und baut auf den bereits vorhandenen IT- und OT-Investitionen einer Anlage auf.
Die Maschine wird immer eine wichtige Rolle spielen. Doch im Zeitalter der KI ist eines der wertvollsten Güter in der Fertigung das geregelte Datenprodukt, das aus den Signalen dieser Maschine erstellt wird.